Hugging Face 实现跨节点异步强化学习训练
本文要点
- Hugging Face 用存储桶和代理替代 NCCL,让 LoRA 异步 GRPO 训练跨节点运行。
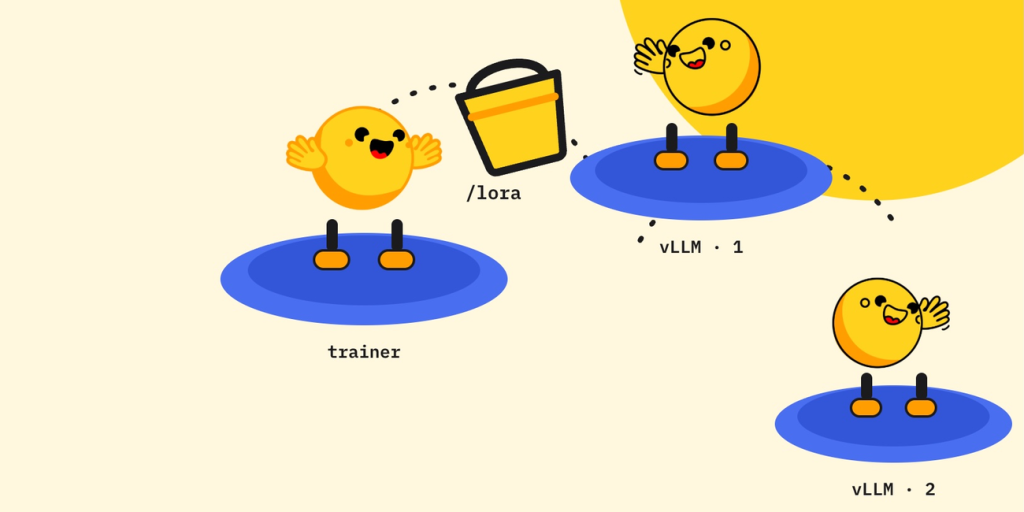
Hugging Face 团队近日发布技术博客,介绍了如何在 Hugging Face Jobs 上实现异步 GRPO 训练。核心思路是放弃传统的 NCCL 通信方式,改用存储桶存放 LoRA 适配器,并通过代理服务器按 KV 前缀路由推理请求。训练端和推理端不再需要共享同一台机器或同一文件系统,vLLM 可以同时加载多个适配器版本,旧任务用旧策略跑完,新任务用最新策略。整个方案基于 TRL v1.14 中新增的 LoRA 支持,适配器体积仅几 MB,远小于完整模型的数 GB。 这一方案的重要性在于降低了强化学习训练对基础设施的要求。以往异步训练依赖 NCCL 组或共享文件系统,通常需要集群环境。现在只需多个独立的 Hugging Face Job 容器即可搭建训练和推理分离的流水线,单节点上限 8 张 H200。对于资源有限的研究团队来说,这意味着不必拥有大规模集群也能跑异步 RL 训练。LoRA 适配器的小体积让权重同步开销大幅降低,vLLM 的多适配器加载能力则保证了推理的连续性。 对从事大模型强化学习训练的研究者和工程师来说,这篇博客提供了可直接参考的工程方案。TRL 的 AsyncGRPOTrainer 已经支持 LoRA 训练,读者可以按照博客中的架构在自己的 Hugging Face Jobs 上复现。博客还记录了五次调优实验,从训练端跟不上推理端、到调整微批次、关闭重计算、增加推理副本、放开在途请求上限,逐步定位瓶颈。这些调优经验对实际部署有参考价值。
会员留言