Sakana AI 让模型自我监督自我提升
本文要点
- Sakana AI 与 UC Berkeley 提出 MASS 方法,让单个大模型自我解题、自我评判并自我优化,但共享盲点可能让错误被当成进步固化进下一轮训练。
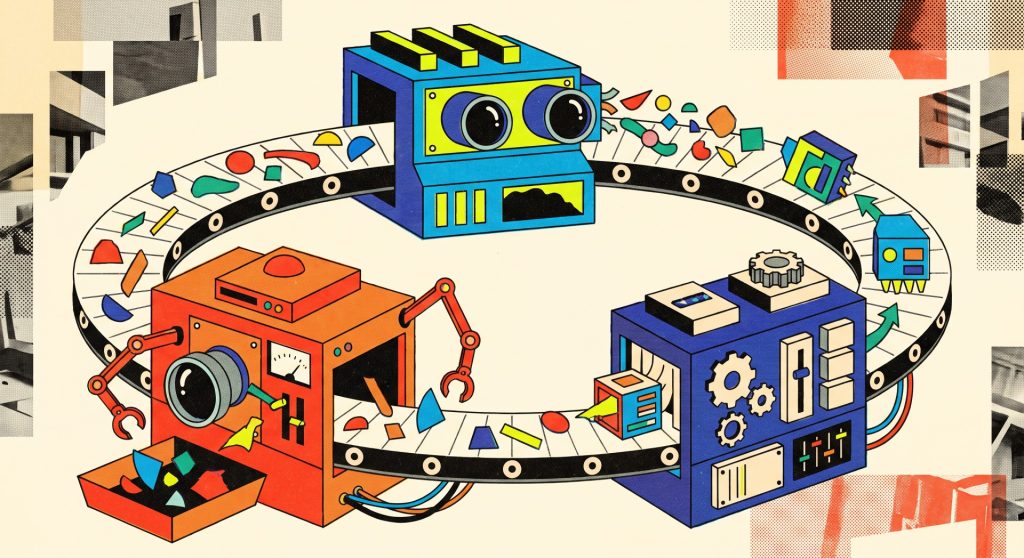
Sakana AI 与 UC Berkeley 的研究者提出多智能体自我监督方法 MASS,核心是让同一个语言模型同时扮演三个角色:把任务分派给自身的多个副本去执行,由自我评估器把结果与当前最优方案对比,再由自我优化器改写下一轮的工作流程。模型权重在内层循环中保持冻结,只调整提示中的工作流文本;外层循环则让最优方案对每项任务运行十八次,由模型自行排序并挑出最多十五次用于训练。两轮之后,对基础模型的胜率接近七成。 这件事值得关注的地方在于,它绕开了递归自我提升长期依赖的“更强教师模型”或外部标注。论文指出,在等离子体研究等前沿领域,验证一个结果本身就要消耗上亿 CPU 小时,人类专家也未必判断得了,模型反而可能是当下最可用的裁判。但风险同样明确:解题、评判、修订都由同一模型完成,它看不见自己的盲区,评估器有时会把有缺陷的步骤或被人为操纵的答案判为成功,这些错误会作为“进步”写进下一轮训练数据,形成自我强化的偏差。 对关注模型训练成本和方法的人来说,MASS 提供了一条不依赖外部强模型的自提升路径,适合在缺乏可靠验证手段、又需要持续迭代的任务上参考。对工程团队而言,更实际的启示是:用同一模型自评自改时,必须额外设计独立校验或外部信号,否则性能曲线上升的同时,错误也可能被系统性地固化下来。
会员留言